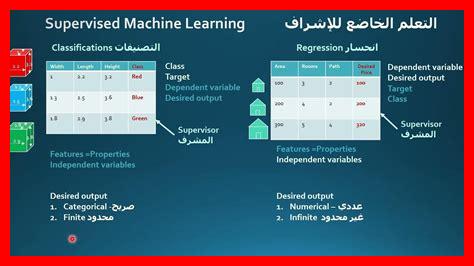
يُعتبر التعلم الخاضع للإشراف أحد أهم فروع الذكاء الاصطناعي، حيث يعتمد على استخدام البيانات المصنفة لتدريب النماذج. في هذا المقال، سنستعرض كيفية تصنيف البيانات في هذا النوع من التعلم، مع التركيز على الأساليب والتقنيات المستخدمة.
ما هو التعلم الخاضع للإشراف؟
التعلم الخاضع للإشراف هو عملية تعليم الآلات كيفية اتخاذ القرارات بناءً على بيانات مدخلة مصنفة مسبقًا. حيثما يتم استخدام مجموعة من البيانات التي تحتوي على مدخلات (الخصائص) ومخرجات (التصنيفات) لتدريب النموذج.
خطوات تصنيف البيانات
لتصنيف البيانات في التعلم الخاضع للإشراف، يتم اتباع عدة خطوات رئيسية:
جمع البيانات: يتم جمع البيانات من مصادر مختلفة، مثل قواعد البيانات أو الإنترنت.
تنظيف البيانات: يتطلب الأمر إزالة القيم المفقودة أو غير الصحيحة لضمان جودة البيانات.
تحديد الخصائص: يتم اختيار الخصائص المهمة التي ستستخدم في عملية التصنيف.
تقسيم البيانات: تُقسم البيانات إلى مجموعتين: مجموعة التدريب ومجموعة الاختبار.
تدريب النموذج: يتم استخدام مجموعة التدريب لتعليم النموذج كيفية التصنيف.
اختبار النموذج: تُستخدم مجموعة الاختبار لتقييم أداء النموذج.
تقنيات تصنيف البيانات
توجد العديد من التقنيات المستخدمة في تصنيف البيانات، ومن أبرزها:
1.
. الانحدار اللوجستي
يُستخدم الانحدار اللوجستي لتصنيف البيانات الثنائية. حيثما يعتمد على حساب احتمالية انتماء البيانات إلى فئة معينة.
2. شجرة القرار
تعتبر شجرة القرار من الطرق البصرية لتصنيف البيانات. هكذا، يتم تقسيم البيانات إلى فئات بناءً على خصائص معينة.
3. الشبكات العصبية
تُستخدم الشبكات العصبية في تصنيف البيانات المعقدة. كما أنها تعتمد على بنية مشابهة لعمل الدماغ البشري.
4. آلات الدعم الناقل (SVM)
تُستخدم آلات الدعم الناقل لفصل البيانات إلى فئات مختلفة باستخدام حدود معينة. من ناحية أخرى، تعتبر فعالة في التعامل مع البيانات ذات الأبعاد العالية.
أهمية تصنيف البيانات
تُعتبر عملية تصنيف البيانات في التعلم الخاضع للإشراف ضرورية للعديد من التطبيقات، مثل:
تحليل المشاعر: يُستخدم لتحديد مشاعر المستخدمين تجاه منتج معين.
التعرف على الصور: يُستخدم في تطبيقات مثل التعرف على الوجوه.
التنبؤ بالاتجاهات: يُستخدم في مجالات مثل التسويق والتمويل.
التحديات التي تواجه تصنيف البيانات
على الرغم من الفوائد العديدة، إلا أن هناك بعض التحديات التي قد تواجه عملية تصنيف البيانات، مثل:
عدم توازن البيانات: حيثما قد تكون بعض الفئات ممثلة بشكل أكبر من غيرها.
الضوضاء في البيانات: يمكن أن تؤثر البيانات غير الصحيحة على أداء النموذج.
اختيار الخصائص: قد يكون من الصعب تحديد الخصائص الأكثر أهمية.
في النهاية
يُعتبر تصنيف البيانات في التعلم الخاضع للإشراف عملية معقدة تتطلب فهمًا عميقًا للبيانات والتقنيات المستخدمة. كما أن النجاح في هذه العملية يعتمد على جودة البيانات والتقنيات المستخدمة. بناءً على ذلك، يُنصح بالاستمرار في التعلم والتطوير في هذا المجال المتطور.
للمزيد من المعلومات حول التعلم الخاضع للإشراف، يمكنك زيارة ويكيبيديا.
إذا كنت تبحث عن المزيد من المقالات المفيدة، يمكنك زيارة وحدة الوظائف.